Ultra-Fast AI Inference at 10 GSPS Detects Particle Pile-Up in Real Time
An FPGA-based CNN localizes every particle in the spill at GSI/FAIR with 300 ns latency while processing 120 Gbit/s, even when detector pulses overlap.
www.spdevices.com
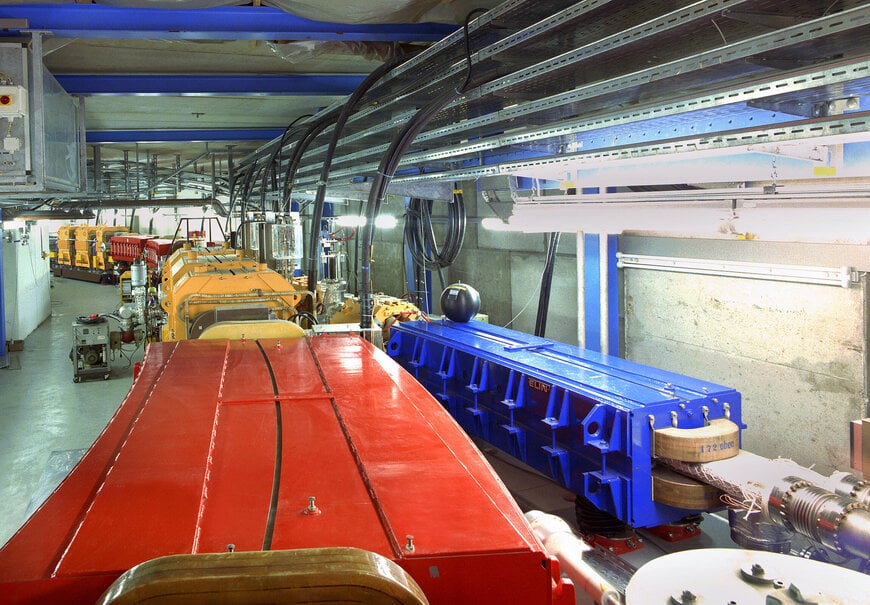
La inferencia de IA basada en FPGA a 10 gigamuestras por segundo (GSPS) en el Teledyne ADQ35 permite localizar partículas de forma fiable y precisa en el GSI Helmholtzzentrum für Schwerionenforschung de Darmstadt, Alemania, en tiempo real, con una latencia inferior a un microsegundo y una resolución temporal inferior a un nanosegundo, incluso a altas tasas de partículas y con un solapamiento significativo de las señales. El trabajo se llevó a cabo como parte de una investigación doctoral en la Universidad de Ciencias Aplicadas de Fulda, en colaboración con GSI. Una red neuronal convolucional (CNN) implementada directamente en hardware FPGA procesa 120 gigabits de datos por segundo con una latencia de tan solo 300 nanosegundos.
Contar cada partícula del spill
Los aceleradores de partículas generan haces de partículas controlados con precisión para experimentos científicos, investigación de materiales y aplicaciones médicas. En GSI, el sincrotrón SIS18 acelera las partículas en el anillo acelerador y posteriormente dirige el haz hacia los experimentos mediante la extracción de partículas del haz, el denominado spill. Para controlar el spill, es fundamental conocer cuántas partículas contiene y cómo se distribuyen en el tiempo. Para ello, es necesario localizar en tiempo real cada partícula del spill mientras el acelerador está en funcionamiento, lo que constituye un importante reto para la instrumentación de haces de los aceleradores de partículas.
Se coloca un detector en el haz que genera un pulso por cada partícula que lo atraviesa. Esto se ilustra en la Figura 1. Si varias partículas atraviesan el detector en un intervalo de tiempo corto, los pulsos se solapan y la respuesta del detector puede volverse no lineal. Este fenómeno de solapamiento de pulsos se denomina pile-up, y su probabilidad aumenta con una mayor intensidad del haz. Si los eventos de pile-up no pueden resolverse correctamente, deben evitarse, lo que limita la intensidad del haz.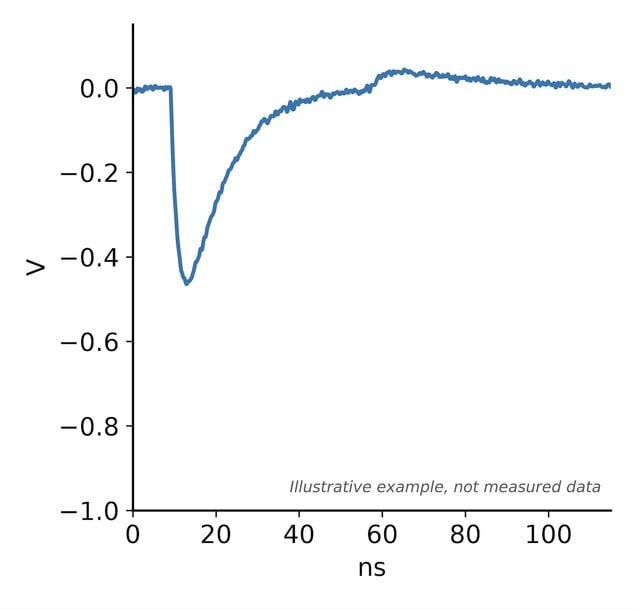
Figura 1. El pulso generado cuando una partícula incide en el detector.
La Figura 2 muestra cuatro ejemplos de este fenómeno de pile-up. Cada ejemplo muestra la respuesta de la señal cuando tres partículas llegan en un intervalo de tiempo corto. El instante de llegada de cada partícula se muestra mediante una línea verde discontinua.
Los métodos tradicionales, como la detección mediante múltiples umbrales o la búsqueda de máximos locales, tienen dificultades y a menudo no consiguen detectar las partículas cuando se produce pile-up. Esto provoca un recuento inferior al real, lo que puede perjudicar el control del spill y los experimentos posteriores.
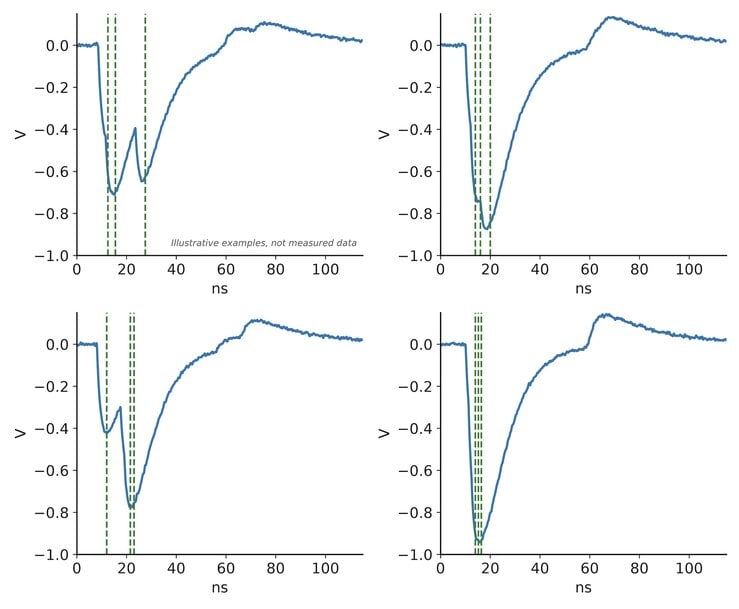
Figura 2. Respuesta del detector cuando varias partículas llegan en un intervalo de tiempo corto. Llegan tres partículas y sus pulsos se solapan.
Procesamiento de señales basado en IA sobre FPGA
Para abordar este reto, se desarrolló y entrenó una CNN con datos etiquetados. Posteriormente, se implementó directamente en hardware FPGA mediante una cadena de herramientas desarrollada por UFAIRA.
El modelo de IA localiza cada pulso individual, incluso cuando se produce pile-up, y extrae en tiempo real tanto el número de partículas como la información sobre el instante de llegada. Esto permite reconstruir con precisión el spill incluso a tasas muy elevadas. La implementación de la CNN en FPGA procesa los datos en línea y garantiza una latencia determinista, un aspecto muy importante para aplicaciones en tiempo real como el control del spill.
Implementación en el digitalizador
La solución se ha implementado utilizando el digitalizador de alta velocidad Teledyne SP Devices ADQ35, con frecuencias de muestreo de hasta 10 GSPS y una FPGA AMD Kintex UltraScale KU115 integrada. Esto proporciona abundantes recursos de cálculo para realizar inferencia de IA en tiempo real directamente en el digitalizador. Al procesar los datos directamente en el digitalizador, el sistema evita los cuellos de botella en la transferencia de datos y permite trabajar con una latencia inferior a un microsegundo.
Mediante una cadena de herramientas para el entrenamiento optimizado para FPGA y consciente del hardware, así como para la implementación de la CNN en la lógica programable de la FPGA, la CNN implementada puede procesar 32 muestras en paralelo a 312,5 MHz, alcanzando 10 GSPS, con una latencia baja y determinista y una elevada precisión.
300 ns de latencia a 120 Gbit/s
La CNN implementada alcanza una latencia de tan solo 300 nanosegundos y procesa 120 gigabits por segundo (10 GSPS, con 12 bits por muestra). Utiliza menos del 15 % de los recursos DSP disponibles y menos del 6 % de los recursos LUT disponibles en la FPGA, dejando así un amplio margen para modelos aún mayores o para alcanzar un mayor rendimiento.
El enfoque basado en IA mejora significativamente el rendimiento en condiciones de pile-up y supera a los métodos tradicionales, como la detección mediante múltiples umbrales y la búsqueda de máximos locales. La CNN localiza los pulsos individuales en eventos de pile-up con una fiabilidad tal que ya no es necesario evitar el pile-up reduciendo la tasa de partículas. Esto permite al sistema funcionar a tasas de partículas mucho más elevadas sin necesidad de modificar el hardware del detector.
¿Cuándo resulta útil la IA en el procesamiento de datos en tiempo real y alta velocidad?
Este ejemplo demuestra que la IA resulta especialmente relevante cuando se producen varios eventos dentro del mismo intervalo de tiempo y generan una señal superpuesta. Sin embargo, la IA también puede ser útil cuando el procesamiento de la señal es demasiado complejo para los métodos tradicionales o cuando las formas de onda varían debido a efectos del mundo real, como deriva, ruido y no linealidad. Los modelos de IA pueden aprender comportamientos complejos de las señales y extraer información que resulta difícil o imposible de recuperar en tiempo real mediante métodos tradicionales.
El enfoque demostrado aquí tiene una amplia aplicabilidad en ámbitos de datos de alta velocidad que requieren procesamiento en línea y de baja latencia, como la monitorización de espectro en tiempo real y la clasificación de señales, la estimación de canal en sistemas de RF, el trading de alta frecuencia, la detección de intrusiones en redes, el procesamiento de imágenes para sistemas autónomos y muchos otros.
Acerca de UFAIRA
Los métodos y la cadena de herramientas utilizados en esta investigación constituyen ahora la base de UFAIRA, una empresa que desarrolla aceleradores de IA basados en FPGA personalizados para inferencia en tiempo real, fundada en 2026 como spin-off de la investigación doctoral realizada en la Universidad de Ciencias Aplicadas de Fulda.
Más información en: https://ufaira.eu/?utm_source=mepax
Acerca de Teledyne SP Devices
Teledyne SP Devices es pionera en adquisición de datos de alta velocidad y ofrece digitalizadores avanzados y soluciones de procesamiento de señales para aplicaciones exigentes en todo el mundo. Con una larga trayectoria de innovación, incluido su liderazgo inicial en tecnología de digitalizadores de 10 GSPS, ayudamos a nuestros clientes a capturar y procesar datos con mayor rapidez, precisión y eficiencia.
Más información en: https://www.spdevices.com/en-us?utm_source=mepax